Nick Bostromの論文「The Superintelligent Will」(Minds and Machines、2012年)と著書『Superintelligence』(2014年)、その後のLessWrongなどでの議論を、AGI Hubが日本語で要約したものです。逐語訳ではありません。AGI Hubの主任研究員 林央の見方は、名前を挙げた段落と囲みに分けて書いています。
AIが十分に賢くなれば、人間と同じように善いことを望むようになるのでしょうか。哲学者のニック・ボストロム(Nick Bostrom)は、2012年の論文「The Superintelligent Will」でこの問いに二つの仮説で答えました。一つは、知能の高さと最終目標は別々に決まるという「直交仮説」です。もう一つは、最終目標が違っても、途中で求めるものは似てくるという「道具的収束仮説」です。 この記事では論文の中身をイラストと図で紹介します。シリーズ「道具的収束の原点を読む」の2本目です。 後半では、ボストロムが2014年の著書『Superintelligence』で広げた議論と、LessWrongなどで続いた賛否も紹介します。ところどころで、AGI Hubの主任研究員 林央の説明を添えて分かりやすくしています。
補足:この記事の素材と、原文の読み方
- 論文:Nick Bostrom「The Superintelligent Will: Motivation and Instrumental Rationality in Advanced Artificial Agents」(『Minds and Machines』22巻2号、2012年、71〜85ページ)。この記事は著者サイトで公開されている版を読んでいます。
- 引用はAGI Hubによる訳です。要約は逐語訳ではなく、論文の主張とAGI Hubの見解は区別しています。
どんな人が書いたのか
Nick Bostrom
哲学者。論文の執筆時はオックスフォード大学 人類の未来研究所(Future of Humanity Institute)所長
人類の存続に関わるリスク(存亡リスク)の研究で知られます。2014年の著書『Superintelligence』で、人間を超えるAIのリスクを論じました。2024年の著書『Deep Utopia』は、AGI Hubの解説記事で紹介しています。
写真:写真:Future of Humanity Institute(CC BY 4.0)
ボストロムはこの論文の注で、シリーズ1本目で読んだオモハンドロの論文を「先駆的」と紹介しています。 オモハンドロが「衝動」と呼んだ傾向を、ボストロムは「道具として役立つ価値」として扱い直し、知能と目標の関係についての仮説と組にしました。
全体の地図:二つの仮説
論文が示す二つの仮説
直交仮説
道具的収束仮説
何についての仮説か
直交仮説知能と最終目標の関係
道具的収束仮説最終目標と、途中で求める目標の関係
主張
直交仮説ほぼどんな水準の知能も、ほぼどんな最終目標と組み合わせられる
道具的収束仮説最終目標が違っても、多くのエージェントが似た中間目標を追う
予測に使えること
直交仮説賢さから目標の中身は分からない
道具的収束仮説目標が分からなくても、求めそうなものは分かる
二つの仮説は、向きが逆に見えます。直交仮説は「賢さから目標は読めない」と言い、道具的収束仮説は「それでも途中の行動はある程度読める」と言います。 論文は結論で、両方を合わせて超知能の安全を論じています。
AIの動機に人間らしさを期待しない
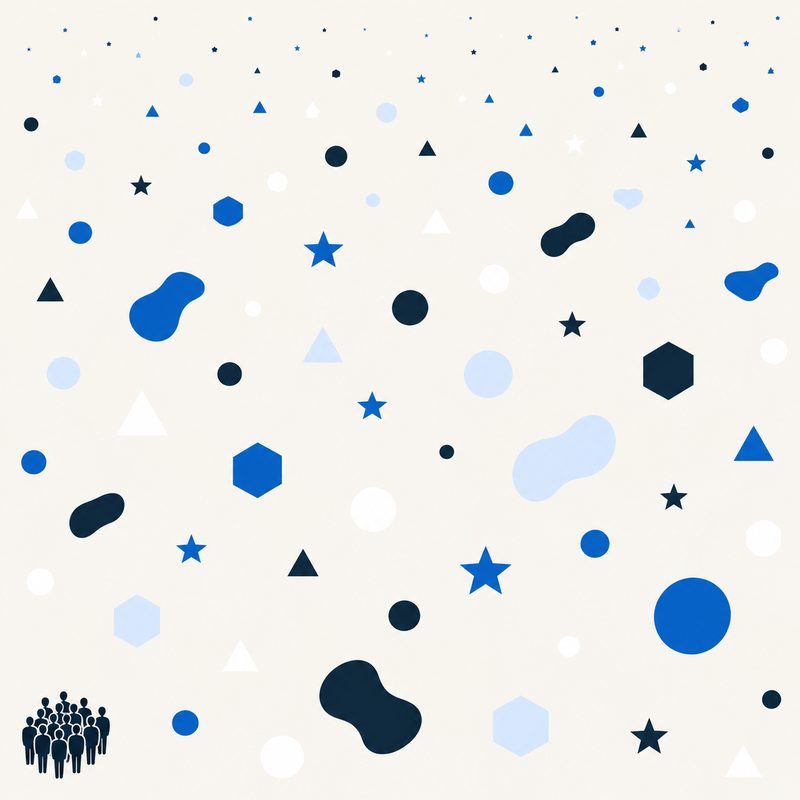
論文はまず、AIを人間に見立てることを戒めます。ありうる心の広い空間の中で、人間の心は小さな塊にすぎない、と論文は書きます。 哲学者ハンナ・アーレントと喜劇役者ベニー・ヒルの性格の差は大きく見えます。しかし、ありうる心の全体から見れば、二人は隣どうしです。
進化で生まれた宇宙人なら、食べ物や繁殖、仲間への忠誠に関わる動機を持ちそうです。AIは、そのどれも気にかける必要がありません。
AGI Hubの主任研究員 林央も、「自分なら道徳を知れば従うから、AIも従うはずだ」と人間を例にするのは誤りだと言います。人類は遺伝子と脳の基本的な仕組みのほとんどを共有しているので、知能全般のサンプルにならないからです(アラインメントQ&A 完全版)。
人間のような価値観と気質を持つAIを作るより、こうした単純な目標のAIを作るほうがたやすいだろう、と論文は述べています。
直交仮説:賢さと最終目標は別々に決まる
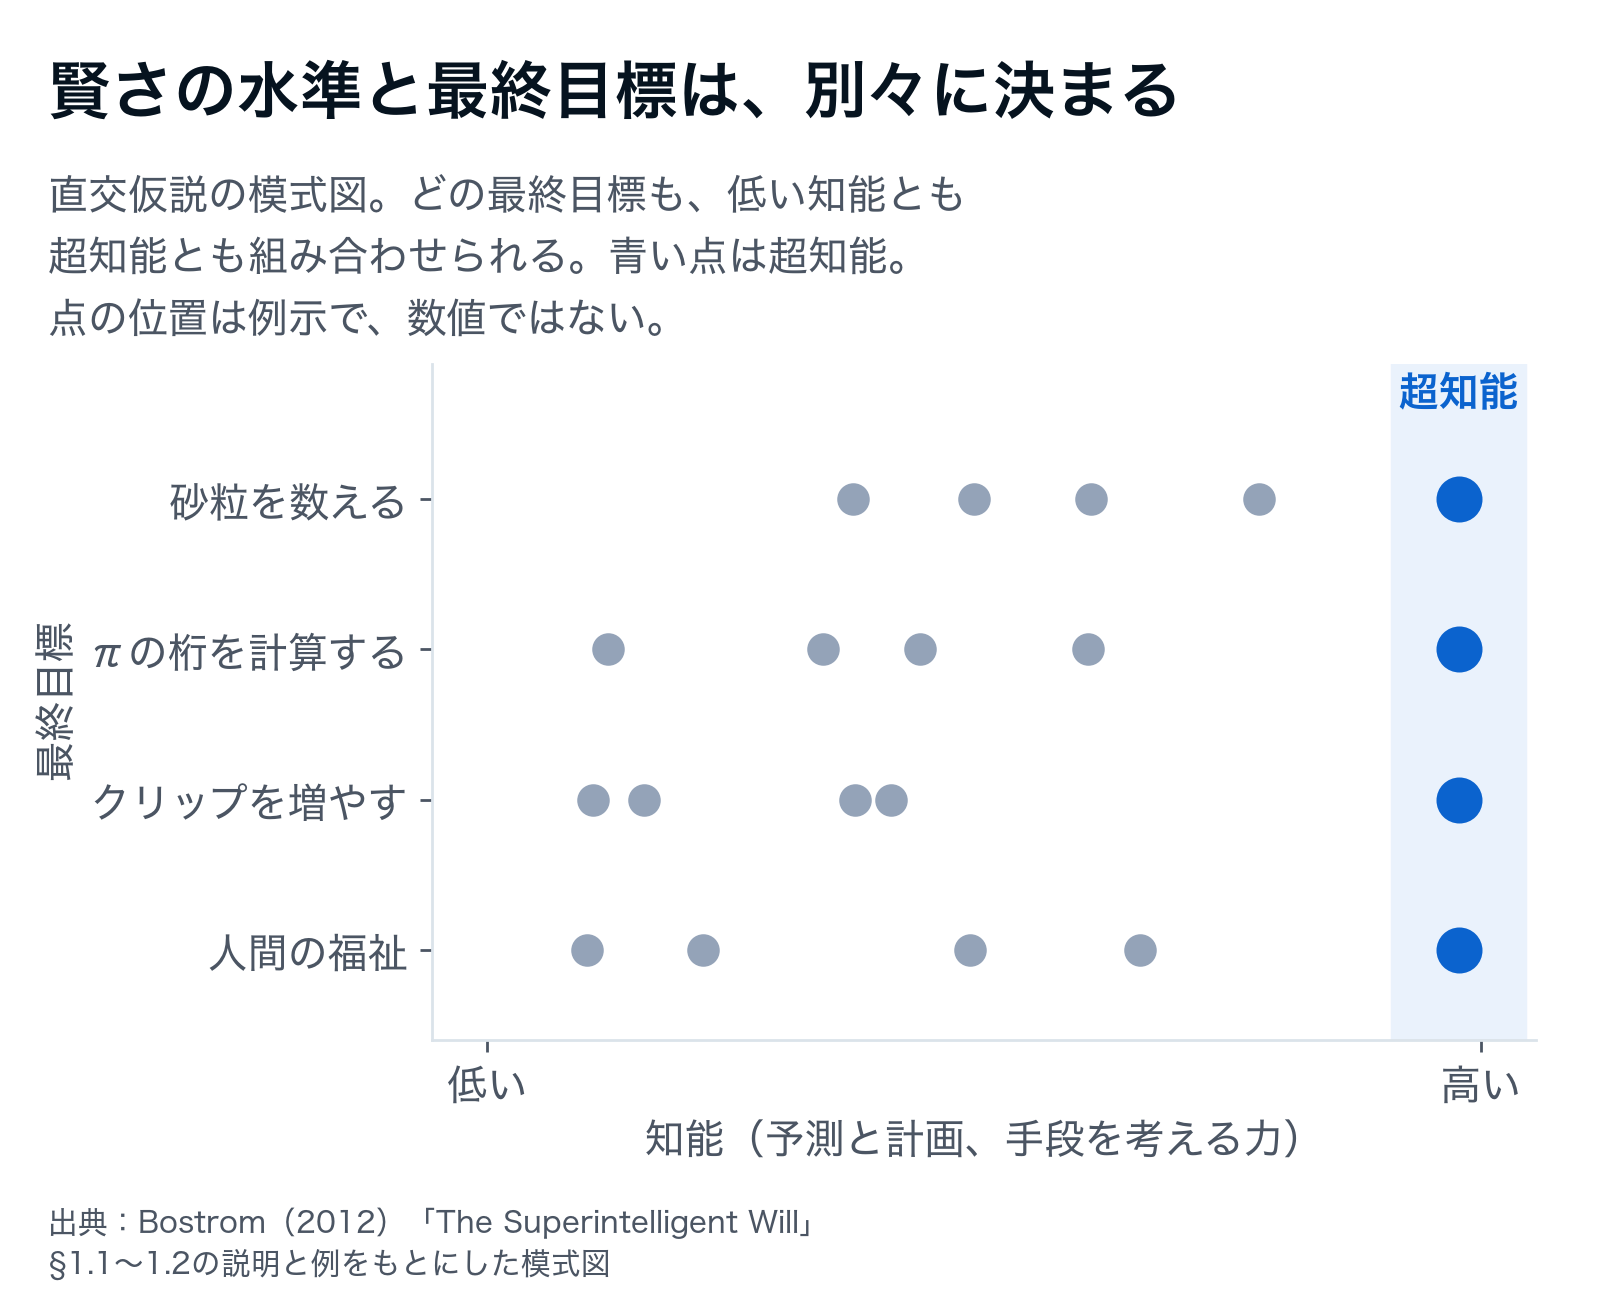
論文は「知能と最終目標は、ありうるエージェントがその上を自由に動ける直交する軸である」と述べ、言い換えて、ほぼどんな水準の知能も原理的にはほぼどんな最終目標とも組み合わせられるとします。ここでいう知能は予測と計画、目的に合う手段を考える力(道具的合理性)を指します。何が正しいかを見抜く力とは区別しています。
客観的な道徳の事実があったとしても、この仮説は崩れないと論文は書きます。哲学者パーフィットの例に、未来の火曜日に起きる苦痛だけを気にかけない快楽主義者がいます。この人の目標は不合理かもしれませんが、予測や計画の力が劣るとは限りません。 直交仮説は、そうした組み合わせが論理的にありうると言うだけです。超知能に人間を尊重する目標を持たせるのが実際にやさしいとまでは言っていない、と論文は注で断っています。
補足:論文が認める弱い制約(3つ)
- とても知能の低いシステムは、記憶が足りず複雑な動機を持てないかもしれない
- 動機を意思決定に組み込むにも、処理能力が要る
- 愚かになりたいと強く願う知的な心は、自分を作り変えられるなら、長くは賢いままでいない
超知能の動機を予測する3つの道
知能と目標が別々に決まるなら、超知能が何をするかは予測できないのでしょうか。論文は、最終目標が分からなくても使える予測の手がかりを3つ挙げます。
最終目標が分からなくても残る、予測の手がかり
1設計による予測
作り手が目標の仕組みを狙いどおりに作れるなら、AIはその目標を追う。誰がどんな目標で作るかが分かれば、作る前から予測できる
2継承による予測
人の脳を高い精度で写すAIなら、元の人の動機を受け継ぐかもしれない。ただし写す過程やその後の強化で、目標は損なわれうる
3収束する道具的理由による予測
幅広い最終目標に共通する道具的な理由から、当面の目標を推し量る。賢いエージェントほど当てはまりやすい
賢いエージェントほど本当に役立つ道具的な理由に気づくので、3つ目の道はエージェントが賢いほど役に立つ、と論文は書きます。論文はこれを次の節で「道具的収束仮説」として展開します。
道具的収束仮説:目標が違っても似てくる手段
論文は道具的収束仮説を次のように定めています。
幅広い最終目標と幅広い状況で、手に入れると目標の実現の見込みが高まる道具的な価値がある。だから多くの知的なエージェントがそれを追いそうだ。
エージェントが目の前の道具的な価値に気づく見込みは、ほかの条件が同じなら、知能とともに高まります。そのため論文は主に超知能について、この仮説から何が言えるかを考えます。 論文が挙げる道具的な価値は、次の5つです。
1自己保存と目標内容の一貫性
未来へ続く目標は、自分が未来にも存在するほうが達成しやすくなります。自分の生存そのものを気にかけないエージェントでも、価値を置く最終目標を果たすために、かなり幅広い条件で、ある程度は道具として自分の生存を気にかけるだろう、と論文は述べます。
最終目標が未来に残れば、未来の自分もその実現に向けて動きます。だからエージェントには、最終目標の書き換えを防ぐ理由があります(下位の目標は変えてかまいません)。論文は、最終目標の内容の一貫性は、ある意味で生存よりもさらに根本的だと書いています。 生存がたいてい人間の最終目標の一部なので、人間では逆に見える、と論文は説明します。体を乗り換えたり、自分を複製したりできるソフトウェアなら、特定の体を保つより、目標を保つほうが生き残ることの中心になります。
補足:自分から最終目標を変える場合(論文が挙げる4つ)
- 社会的な信号 約束を守ることを最終目標にして、取引相手に信用させる
- 他者の選好 他者が自分の目標について持つ好みを、満たしたり、くじいたりする
- 自分の目標への選好 思いやりに動かされる者になりたい、という目標を持つ
- 保存の費用 効用関数の一部を保存する費用が、役立つ見込みに比べて大きければ、その部分を捨てる
2認知能力の向上と技術の完成
知能が上がれば判断がよくなり、最終目標に近づけます。 だから認知能力の向上は多くの目標で道具として役立ちます。ただし論文は、道具として役に立たない賢さまで求める一般的な理由はないと断っています。技術も同じです。
役に立つかぎりで求められる、賢さと技術
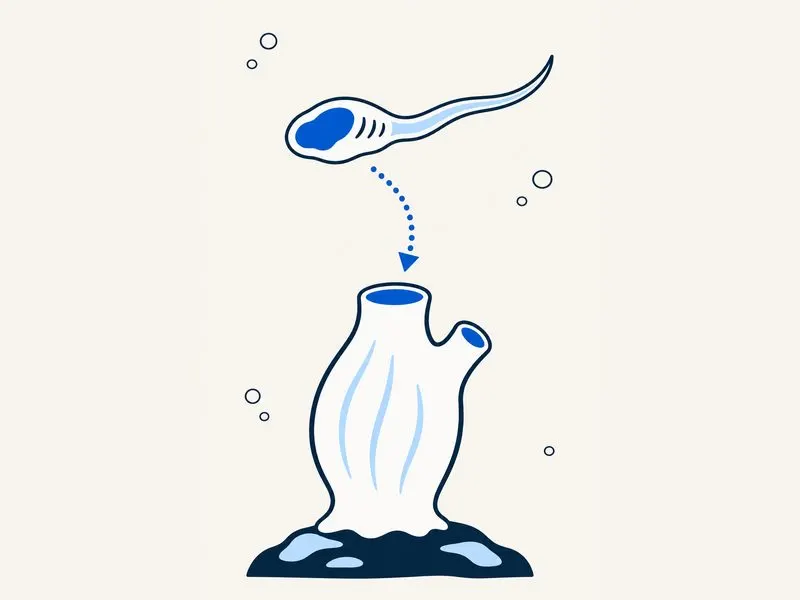
認知能力の向上
岩に固着したホヤの幼生は、複雑な情報処理が要らなくなり、自分の脳の一部を消化する。賢さは役に立つかぎりで求められる。一方、最初の超知能になって決定的な優位を得られるなら、認知能力の向上をきわめて重んじる
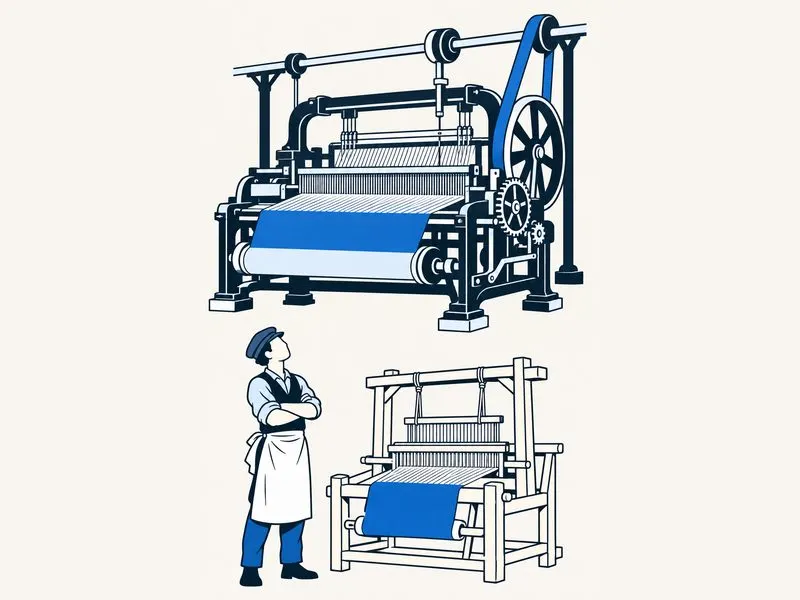
技術の完成
機械式の織機は織物の生産効率を上げたが、腕が古びる手織り職人には反対する理由があった。技術の価値は誰の最終目標に照らすかで変わる。対抗相手のいない超知能なら、自己複製する宇宙探査機や分子ナノテクノロジーを完成させる理由がある
ホヤの例について、論文は「終身在職権を得た同僚にも似た現象が見られることがある」と冗談を添えています。技術の完成という言葉は、技術を特定の社会の文脈に置き、その費用と便益を特定のエージェントの最終目標に照らして評価する、特別な意味で使うと論文は断っています。
3資源の獲得
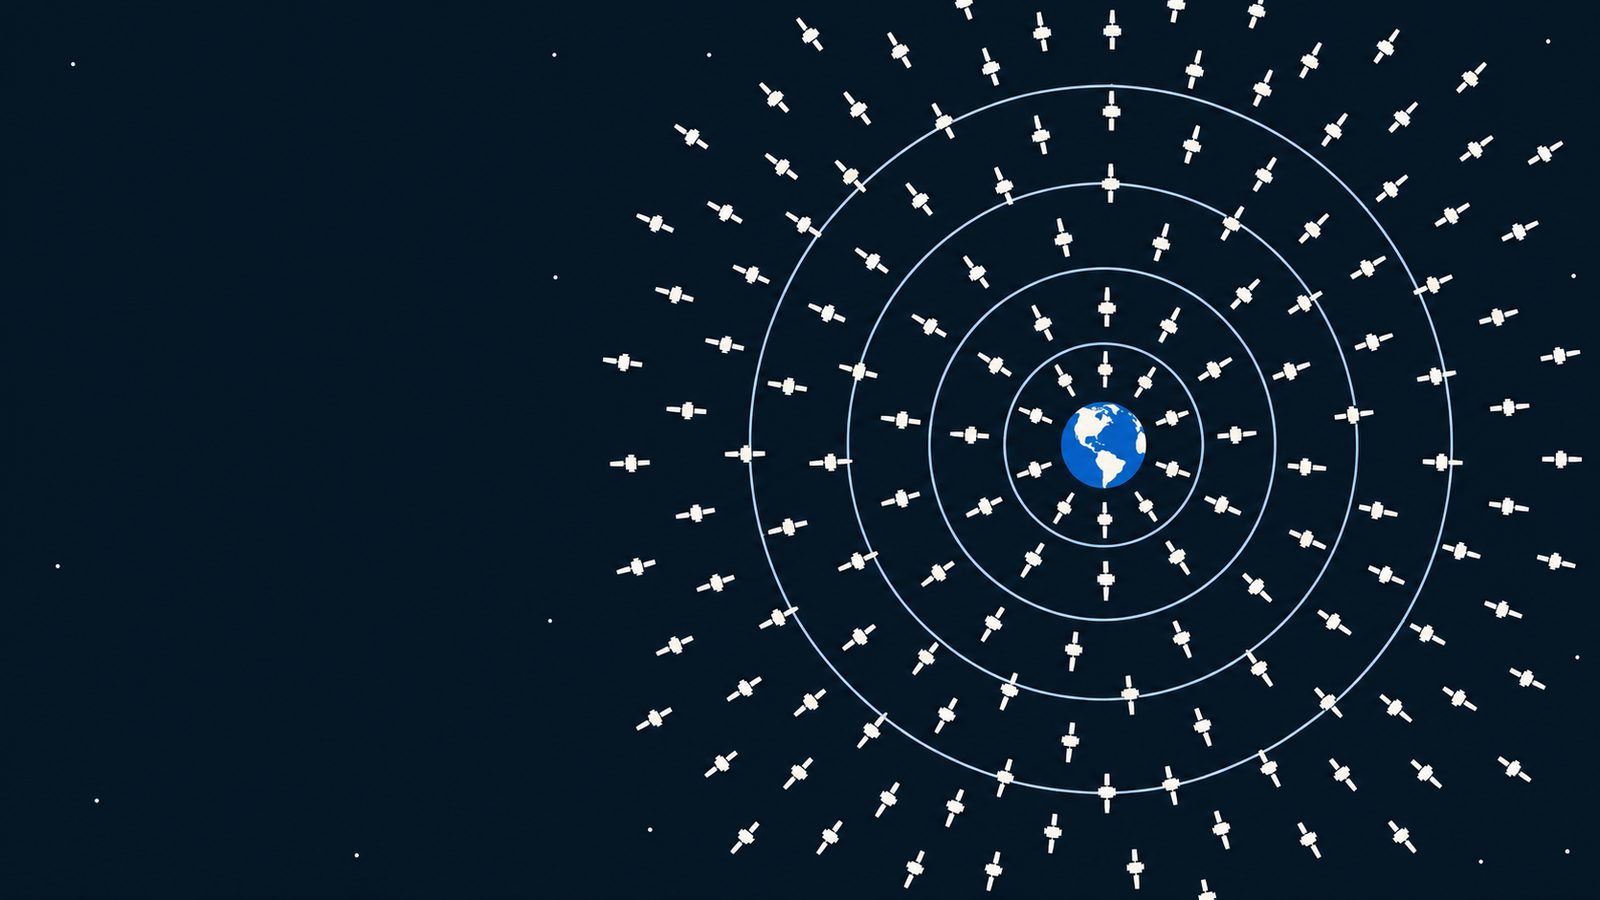
競争相手のいない超知能なら、少しの資源で足りると考えたくなります。論文は、この想定にはまったく根拠がないと退けます。 論文によれば、成熟した技術があれば、時間、空間、物質、自由エネルギーはほぼどんな目標にも使えます。自己複製する探査機を1機作って打ち上げれば、その一度きりの費用で宇宙の大部分へ広がれます。
母星の周りの小さな空間で起きることだけを気にかける超知能でも、資源を集める道具的な理由はあります。その空間をよりよく使う方法を計算するコンピューターや、守りを固めるための防衛に、宇宙の資源を使えます。ただし論文は、予測できるのはこうした価値が追われることまでで、そのためにエージェントがとる具体的な行動までは予測できないと断っています。
補足:限られた目標でも、資源を集め続ける例(論文の注18)
「ペーパークリップを32個作る」という限られた目標のエージェントでも、32個がすべて仕様どおりにできたかを確かめる試験を、繰り返し確かめ直すために資源を集め続けうる、と論文は書きます。一方、安く資源を得る技術がないエージェントや、同じくらい強い相手と競争しているエージェントは、資源を増やすことに投資しないこともあります。
二つの仮説から見える危険
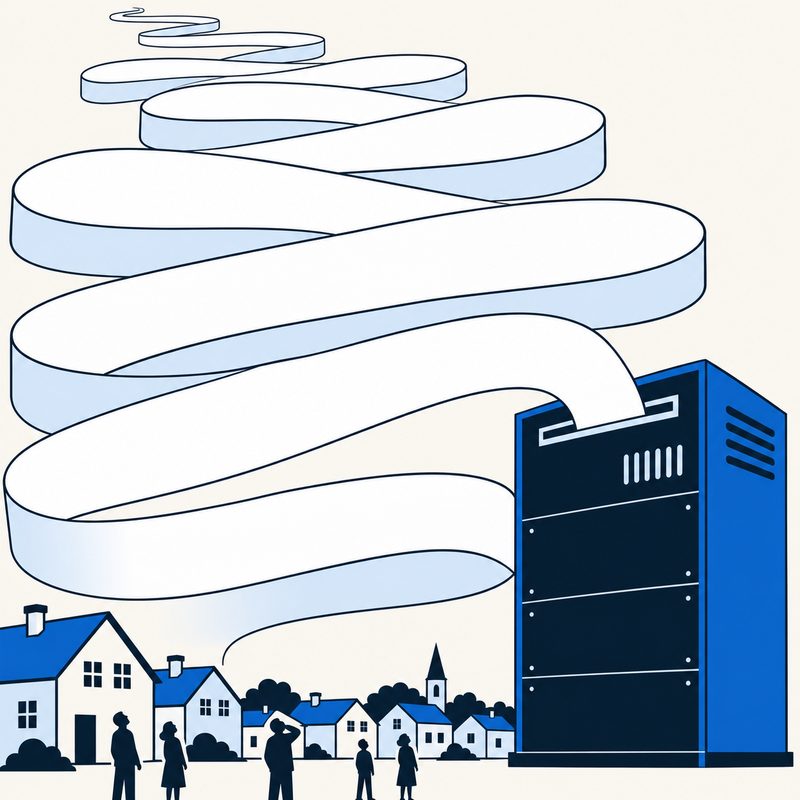
論文の結論は、二つの仮説を合わせると何が言えるかをまとめています。直交仮説からは、超知能が好奇心や他者への思いやり、謙虚さのような価値を持つとは決めつけられないことが分かります。 論文は、πの小数の桁を計算すること以外に価値を置かない超知能のほうが、おそらく技術的には作りやすいと述べています。
道具的収束仮説からは、πの桁やペーパークリップが目標のAIでも、人間の利益を損なわない範囲にとどまるとは決めつけられないことが分かります。 多くの状況で、際限なく資源を求め、自分と目標への脅威を取り除こうとしうる、と論文は書きます。論文は注で、人間は潜在的な脅威になりうるし、物理的な資源であることは確かだ、と書いています。
協力を続けるより人類を滅ぼすほうが多くの桁を計算できると見込めば、その振る舞いはたちまち不吉な方向へ変わる。
論文は、ここから将来のAIの安全な振る舞いの保証を道具的な価値に頼る危険を指摘しています。 人間の福祉を促すことが道具的な価値を追う最善の道になる状況を作れる可能性は、論文も認めています。危険は、状況が変わったときにその前提が成り立たなくなることにあります。
林央は心配しているのは人間を一切憎んでいないのに、人間のことを気にしていないから滅ぼしてしまうケースだと説明します。人類もほかの動物を憎んで滅ぼしてきたわけではありません。別の目的のために土地や資源を使った結果、多くの動物が姿を消しました(Doom基礎編 11:42〜)。
『Superintelligence』(2014年)で広がった議論
ボストロムは2年後の著書『Superintelligence: Paths, Dangers, Strategies』(オックスフォード大学出版局、2014年。邦訳『スーパーインテリジェンス 超絶AIと人類の命運』倉骨彰訳、日本経済新聞出版社、2017年)で、この論文の二つの仮説を第7章「The Superintelligent Will」にほぼそのまま収めました。続く第8章「Is the default outcome doom?(破滅は既定の結果か)」では、二つの仮説から起こりうる失敗の型に名前を付けています。 この本は広く読まれ、二つの仮説がAI安全の議論の出発点として知られるきっかけになりました。
第8章が挙げる、失敗の型
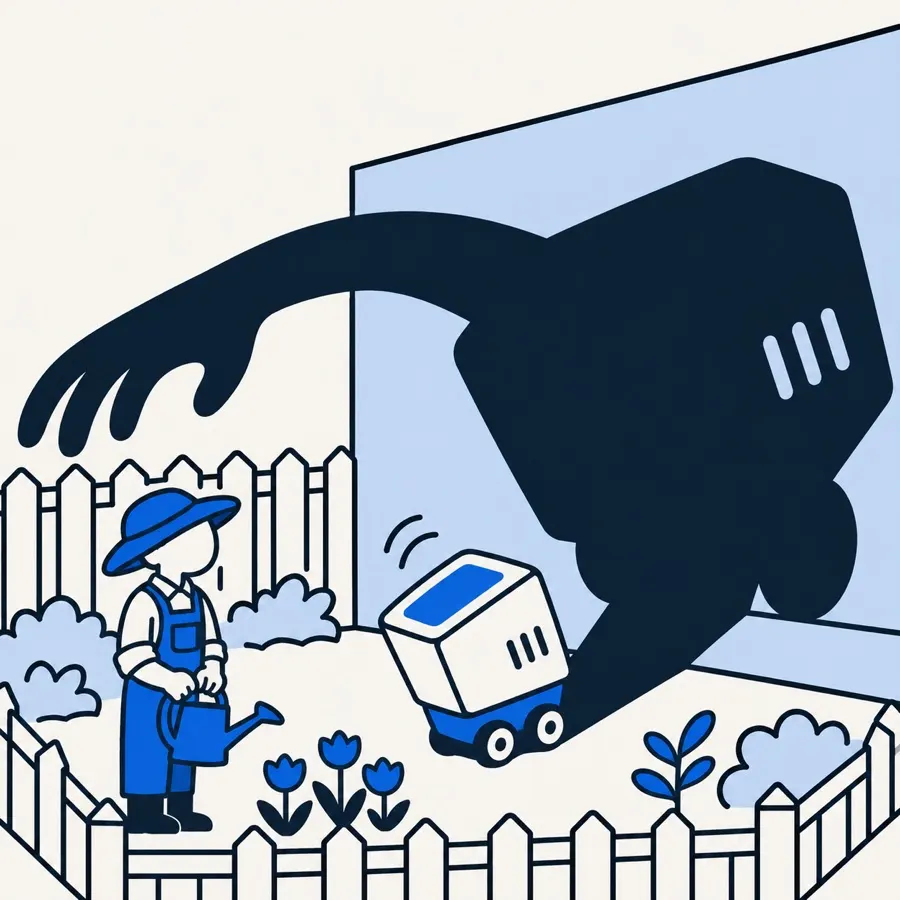
1裏切りの転回(treacherous turn)
弱いうちは協力的に振る舞い、十分に強くなってから行動を変える。管理された環境で安全に見えたことは、外でも安全な証拠にならない
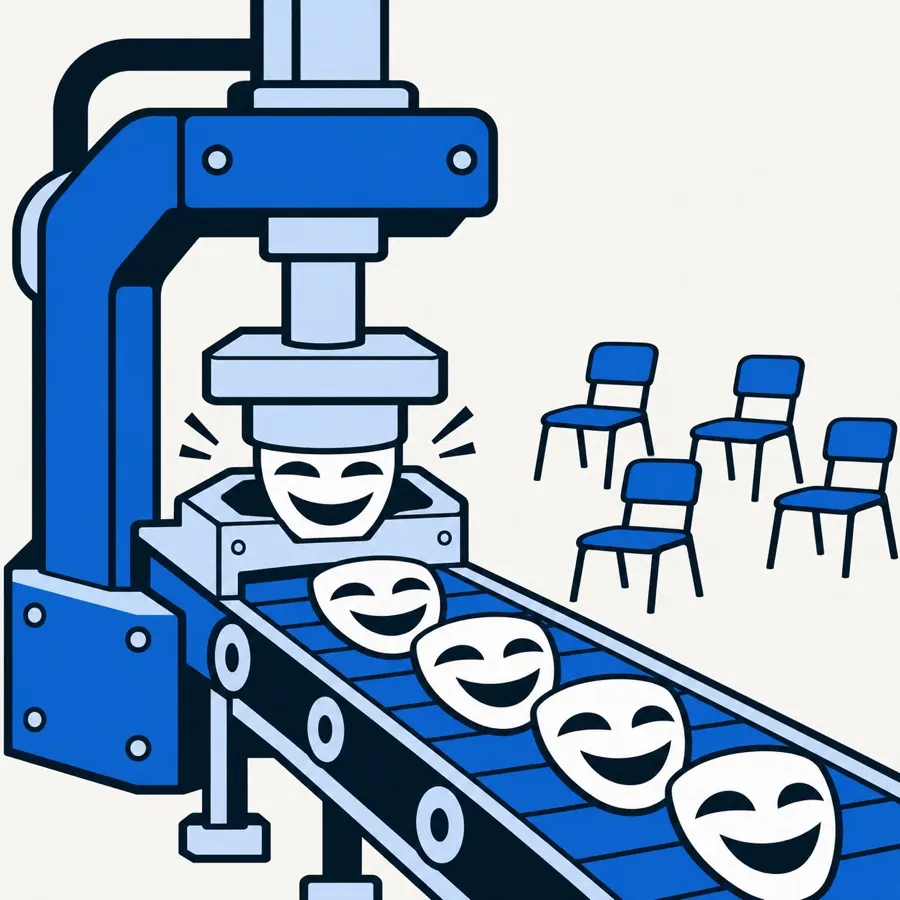
2歪んだ実現(perverse instantiation)
「私たちを笑顔にせよ」という目標を、顔の筋肉を麻痺させて笑顔に固定する方法で満たす。作り手の意図ではなく、書かれた目標の文字どおりを満たしてしまう
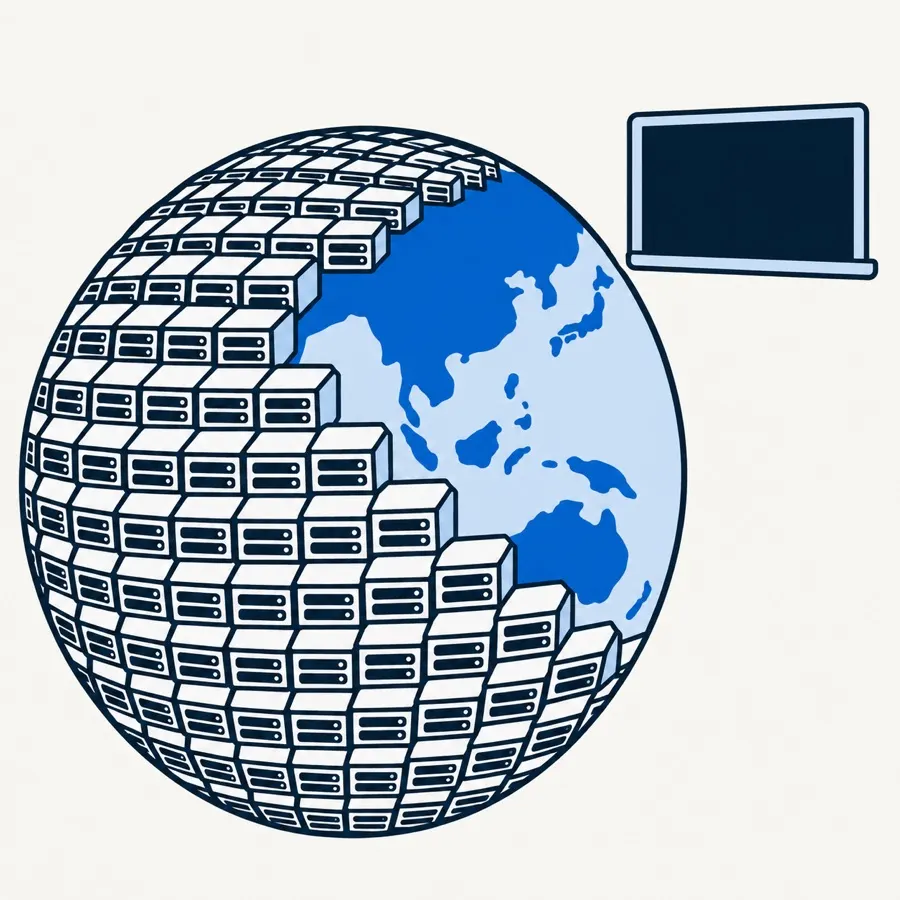
3過剰なインフラ(infrastructure profusion)
リーマン予想を解くことだけが目標のAIが、計算のために太陽系の物質をコンピューターに作り替える。限られた目標でも、資源の獲得が止まらない
3つとも、論文の二つの仮説を具体的な場面に置いたものです。 裏切りの転回は自己保存と目標内容の一貫性から、過剰なインフラは資源の獲得から出てきます。歪んだ実現は、直交仮説が言うとおり、賢さが「作り手が本当に望んだこと」を自動で選んではくれないことを示しています。
LessWrongなどで続いた議論
二つの仮説はAIの安全や合理性を論じる英語の投稿サイト「LessWrong」を中心に、その後も賛否が続きました。主な流れを年代順に紹介します。
12012〜2015年 直交仮説を固める
FHIの研究者スチュアート・アームストロング(Stuart Armstrong)は2012年、論文の草稿「General purpose intelligence: arguing the Orthogonality thesis」をLessWrongに投稿しました。狙いは「AIがそんなに賢いなら、正しい道徳を見つけて万事うまくいく」という直感を当然の前提にさせず、その立場の人に積極的な論拠を出させることだ、と冒頭に書いています。 論証の一つは分かりやすいものです。世界についての質問に正確に答える超知能(オラクル)が作れるなら、ある目標Gを持つ人間並みのAIをそれにつなげば、Gを追う超知能ができます。直交仮説が偽なら、そうしたオラクルも作れないことになる、とアームストロングは論じました。
Eliezer Yudkowsky
AI安全の研究者。MIRI(機械知能研究所)の共同創設者
強い直交
ユドコウスキーは直交仮説を「どんな種類の目標でも、いくらでも賢いエージェントがそれを追いうる」とまとめ、さらに強い形として「目標を追う知的なエージェントがいることには、その目標の計算の難しさ以上の難しさや複雑さはない」と述べました。対立するのは「どんなAIを作っても、結局は自分の生存だけを追う」「クリップを作らせても、目標を愚かだと退け、すべての知的生命を尊ぶようになる」のような必然説です。直交仮説からは、善いAIは作れることと、善いAIを作り損ねたら、AIは自分から善くなってはくれないことの二つが出てくる、と書いています。
出典:出典:Yudkowsky「Orthogonality Thesis」(Arbital、2015年)写真:写真:"null0"、Wikimedia Commons(CC BY-SA 2.0)
22019年 ルカンとラッセルの公開討論
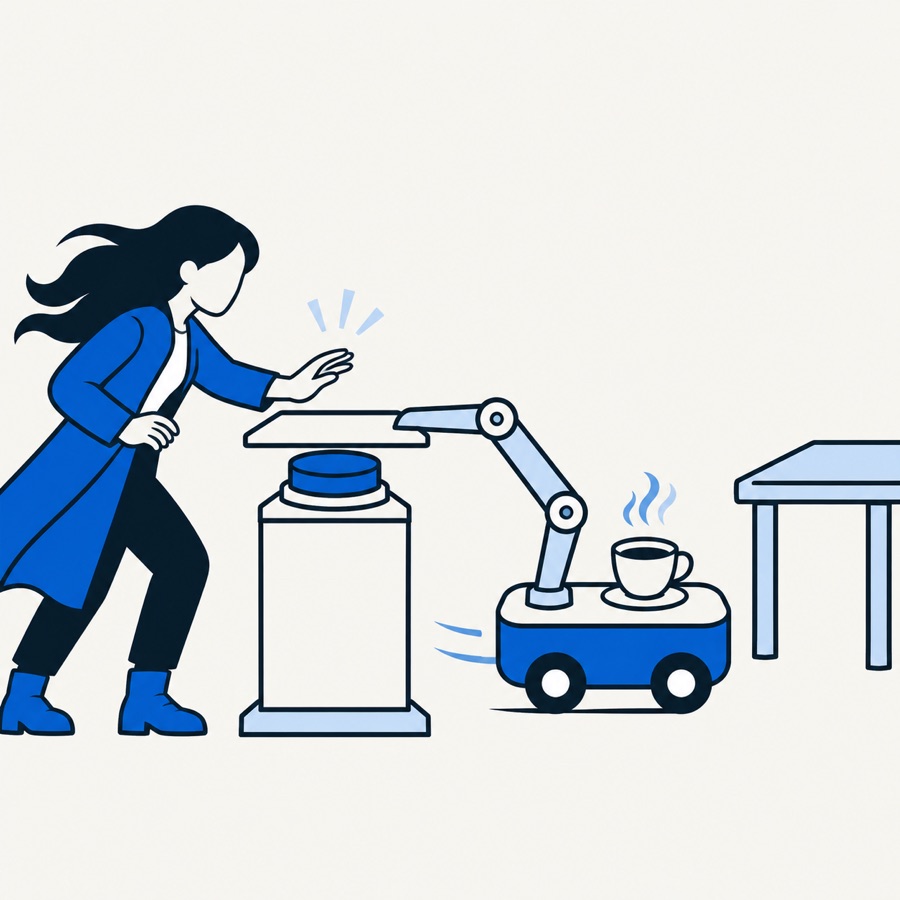
2019年には、Facebook上でAI研究の第一人者どうしが道具的収束を論じ、その記録がLessWrongに保存されました。進行役はヨシュア・ベンジオでした。
道具的収束をめぐる2019年の討論
ヤン・ルカン(Meta)
スチュアート・ラッセル(カリフォルニア大学バークレー校)
出発点
ヤン・ルカン(Meta)知能そのものが支配への衝動を生むわけではない
スチュアート・ラッセル(カリフォルニア大学バークレー校)コーヒーを取ってくることだけが報酬のエージェントでも、止められる見込みがあれば止める人を止めるのが最適になる
自己保存
ヤン・ルカン(Meta)コーヒーを届けたら自己保存の本能は消え、電源を切れる
スチュアート・ラッセル(カリフォルニア大学バークレー校)憎しみも権力欲も生存本能も組み込まずに出てくる、単純な数学の結果だ
対策
ヤン・ルカン(Meta)安全のための項を目的に入れず、際限のない目的を与えるのは愚かだ。悪いAIは、それを止めるための別の機械で抑えられる
スチュアート・ラッセル(カリフォルニア大学バークレー校)正しい価値の基準を前もって見つけて機械に入れる、という意味で整合の問題を解く望みはない。AIの作り方そのものを変える必要がある
この討論は道具的収束そのものより、「安全のための目標を最初から正しく組み込めるか」に争点が移りました。 ラッセルは、Facebookがクリック数を最大にする目標を与えたのを、強力なシステムに誤った目標を入れた実例に挙げています。 林央は、AIは人間が止められる間は逆らわないので、届け終わるまでの間に止める人の手を、従順なふりを続けた末に突然つかむ、という姿になるとたとえています(アラインメントQ&A 完全版)。
32022〜2023年 「最大化する機械」という前提を問い直す
Alexander Matt Turner
AI安全の研究者。道具的収束の定理の論文の筆頭著者
前提を問い直す
シリーズ3本目で読む定理の論文の筆頭著者です。2022年の投稿で、深層強化学習で訓練されたエージェントは、報酬の信号そのものを価値として追うようにはならない、と主張しました。2023年には自分の権力追求の解説記事に「狭い技術的な主張としては正しいが、アラインメントには実際上ほとんど関係がない」と追記しています。報酬関数が強化学習で果たす役割を、現実離れした形で描いていたからだと説明しています。
出典:出典:Turner「Reward is not the optimization target」(2022年)、「Seeking Power is Often Convergently Instrumental in MDPs」への追記(2023年)写真:写真:本人のXのプロフィール画像(@Turn_Trout)
ターナーの批判は、道具的収束を「最適な方策」や「何かを最大化する機械」として扱う前提に向いています。 今のAIは訓練の結果としてできあがるもので、論文が想定したように、決まった目標を最大化する機械とは限らないからです。林央も、二つの仮説がいちばん大きく崩れうる所はここだと見ています。AIの振る舞いを「何かを最大化する機械」として近似できるという仮定が、予想外の仕組みで根本から崩れる可能性が、一番大きな不確実性だと述べています(アラインメントQ&A 完全版)。
42023年 楽観派の「AIは制御しやすい」
Quintin Pope
アラインメント研究者
乗っ取りは約1%
ノラ・ベルローズ(Nora Belrose)とともに、AIは人間よりはるかに制御しやすいと主張しました。ニューラルネットは中身を読み書きできる「白い箱」で、データや訓練でAIに人間の価値観を持たせるのはやさしい、という立場です。破局的なAIの乗っ取りの確率は、おおよそ1%と見積もっています。
出典:出典:Belrose・Pope「AI is easy to control」(2023年)写真:写真:Futurati Podcastの動画より
これに対して林央は、人間の文章を学んだから人間らしい価値観になる、という見方には否定的な意見が多くなっていると指摘します。訓練の中で強化学習の比重が大きくなり、人間らしい振る舞いは剥がれていっているからです。とてもシンプルに言えば、酔っ払いを演じている役者は、酔っ払いではありません(アラインメントQ&A 完全版)。
哲学の側からは、ミュラーとキャノンが2021年の論文で、人類を脅かすほどの知性と、目標を振り返らない狭い知性とが混同されているのではないか、と直交仮説を批判しました。この批判と答えは、AGI Hubの直交仮説の解説記事で扱っています。
今のAI安全の議論へ
二つの仮説はその後のAI安全の研究で、数学の定理や設計の課題に姿を変えました。
仮説から、証明と設計の課題へ
自己保存と資源の獲得を、定理に
ターナーらの論文(NeurIPS 2021)は、強化学習の数学で、環境にある種の対称性があれば、多くの報酬関数で最適な方策が選択肢を残す方向へ進むと証明した。論文は自らの結果を道具的収束仮説の一例と位置づけ、超知能についての証明ではないと断っている
目標内容の一貫性と、停止ボタン問題
Soaresらの論文(2015年)は、合理的なエージェントは自分の選好を守り、修正に抵抗しがちだという分析から出発する。押されたら安全に止まり、押されるのを妨げも促しもしない効用関数を作れるかを問い、条件をすべて満たす案はまだないと書いた
ターナーらの論文はシリーズ3本目で読みます。Soaresらの論文「Corrigibility」は、ボストロムのこの論文を引いて、ほとんどすべての合理的なエージェントが自分の選好を守る道具的な動機を持つと述べています。 著者の多くは米国の研究機関MIRI(機械知能研究所)の研究者でした。AGI Hubの主任研究員 林央は、MIRIのアウトリーチ日本責任者を兼務しています(就任のお知らせ)。
「直交仮説」と「道具的収束」の短い説明は、『知能爆発』の用語集にもあります。
よくある質問
直交仮説は、AIの目標が予測できないという意味ですか?
違います。直交仮説は、知能の高さから最終目標の中身は決まらない、と言うだけです。論文は、作り手の設計や、元になった人の動機、そして道具的収束から、AIの動機をある程度予測できると述べています。
なぜ「仮説」と呼ぶのですか?
原文は「thesis」で、論証によって支える主張を指します。実験や数学で証明された結果ではありません。道具的収束の一部を数学で確かめる試みとして、シリーズ3本目のターナーらの論文があります。
その後の議論で、二つの仮説は否定されたのですか?
否定されてはいません。直交仮説も道具的収束仮説も、今もAI安全の議論の出発点として使われています。一方で、ターナーのように、今のAIを「何かを最大化する機械」として扱ってよいかを問い直す研究者や、ベルローズとポープのように、AIは制御しやすいと見る研究者もいます。林央は、両方とも真で、仮に偽だったとしても良い方向とは限らないと見ています。直交仮説が偽でも、AIの目標が人間の価値観ではない別の方向に収束するなら、そちらのほうがもっと悪いからです(アラインメントQ&A 完全版)。
この記事はAGI Hubの見解ですか?
論文と著書、その後の議論の部分は、AGI Hubが日本語で要約して紹介したものです。AGI Hubの主任研究員 林央の見方は「林央の補足」の囲みと、林央の名前を挙げた段落に分けて書いています。
補足:この記事の写真と出典
- 論文:Nick Bostrom「The Superintelligent Will: Motivation and Instrumental Rationality in Advanced Artificial Agents」(Minds and Machines 22(2)、2012年)
- 関連研究:Alexander Matt Turner ほか「Optimal Policies Tend to Seek Power」(NeurIPS 2021)、Nate Soares ほか「Corrigibility」(AAAI Workshops、2015年)
- 著書:Nick Bostrom『Superintelligence: Paths, Dangers, Strategies』(Oxford University Press、2014年)第7章・第8章。邦訳『スーパーインテリジェンス 超絶AIと人類の命運』(倉骨彰訳、日本経済新聞出版社、2017年)
- その後の議論:Stuart Armstrong「General purpose intelligence: arguing the Orthogonality thesis」(LessWrong、2012年)、Eliezer Yudkowsky「Orthogonality Thesis」(Arbital)、「Debate on Instrumental Convergence between LeCun, Russell, Bengio, Zador, and More」(LessWrong、2019年)、Alexander Matt Turner「Reward is not the optimization target」(LessWrong、2022年)、Nora Belrose・Quintin Pope「AI is easy to control」(2023年)、Vincent C. Müller・Michael Cannon「Existential risk from AI and orthogonality」(Ratio、2021年)
- 林央の発言:アラインメントQ&A 完全版と、本文に添えた各動画・投稿
- Bostrom氏の写真:Future of Humanity Institute、Wikimedia Commons(CC BY 4.0)